人形机器人为什么必须用异构计算?从“算力堆叠”到“实时可靠”的物理 AI 底座
人形机器人要同时跑感知、推理与硬实时运动控制。真正的问题不是“哪颗芯片 TOPS 最高”,而是“哪种架构能让三类负载在同一平台上每一周期都稳定运行”。异构计算正把过去两套嵌入式系统合并为一颗处理器:AMD Ryzen™ AI Embedded X100 系列 + ROCm 开放软件栈 + congatec COM-HPC 模块。
小时候看《星球大战》,C-3PO 和 R2-D2 让无数人第一次意识到:机器可以像人一样与人类互动。如今,这种人形自主机器人已不再只存在于科幻电影里。斯坦福大学机器学习与机器人研究员 Alexander Khazatsky 曾指出:“如果我们成为最后一代看到这些科幻场景尚未成真的人,我不会感到意外。”
在先进计算与人工智能的推动下,人形机器人正在真实世界中改变我们的工作与生活方式。但要把“大脑”做出来,并不只是堆算力那么简单。
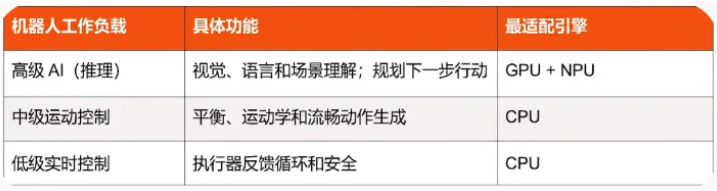
人形机器人是机器人类别中最复杂的形态。它的计算平台必须同时运行三类负载:
这三层各有自己的节奏,对芯片提出完全不同的要求。过去的主流做法是把它们分布在两套嵌入式系统上:
系统 1( deliberative,审慎式):高层 AI 推理,理解场景并规划动作
系统 2( reactive,反应式):中层运动控制 + 底层嵌入式实时反馈
这种分离之所以长期存在,是因为两类负载的数据结构与计算算法根本不同:高层推理是面向吞吐的批量数学运算;反应层则需要严格延迟,处理大量分支的实时任务。但随着异构计算(Heterogeneous Compute)架构成熟,这种“必须分开”的前提正在被打破。
GPU 擅长高层 AI 中大规模并行的感知与视觉语言模型;但机器人必须实时规划、协调与控制,这类工作更适合 CPU。异构计算架构的崛起,让设计者不再需要两套系统。今天,一颗处理器就能完成--AMD Ryzen™ AI Embedded X100 系列在单封装内集成所需计算引擎:
●运动控制与实时反馈跑在统一的 “Zen 5” CPU 核心上,每个周期行为一致,控制环路保持确定性与准时
现代人形机器人可能同时运行多路摄像头、LiDAR、语音、本地 LLM、VLM、操作模型与导航地图。数据采集与管理极具挑战;当控制 CPU 核心性能不足时,调度与同步会带来不必要的延迟。AMD Ryzen AI Embedded X100 系列最多 16 个高性能核心、最高 5.1 GHz 频率,把延迟压到最低。共享统一内存让 CPU、GPU、NPU 直接访问同一数据,相比必须通过 PCIe 传输数据的独立 CPU-GPU 系统,进一步降低延迟。
硬件只是硬币的一面。对机器人工程师来说,芯片的价值取决于工具链与库的暴露程度——这正是 AMD 开源软件路线的意义。ROCm 是 AMD 面向 GPU 加速计算的开放软件栈,提供驱动、库、编译器和 AI 框架,让机器人开发者可以用 AMD GPU 处理计算机视觉、SLAM、运动规划、仿真和机器学习等计算密集型任务。ROCm 支持 PyTorch、TensorFlow 等框架的 GPU 加速,可显著提升自主系统中的推理速度与并行处理性能。
随着机器人更智能、更自主,并面临更多与物理世界交互的要求,胜出的设计将是那些让处理器协同满足“感知—决策—行动”闭环实时需求的方案。congatec 在标准计算机模块(COM)上提供异构平台,例如 AMD Ryzen™ AI Embedded X100 系列。这个模块为机器人开发者提供一个经过验证、标准化的构建块。
当处理器技术与 AI 加速不断演进,OEM 希望在设计中进行扩展并实现下一代产品时,这一点至关重要:只需简单更换模块,就能升级到更高性能等级,而无需完整重新设计。
conga-HPC/cRX1 基于 COM-HPC 外形规格,旨在提供越来越苛刻的机器人负载所需的性能、带宽和高速 I/O 接口。通过把异构计算与模块化、可扩展平台结合,机器人开发者可以把更少时间花在底层计算难题上,把更多时间用于构建能在真实世界中感知、决策和行动的机器人——就像 C-3PO 和 R2-D2 那样。